PROJEKTEINBLICK ·
Joris lernte zu sehen
Mein Assistent konnte mit Beschreibungen arbeiten. Mit Vision kam eine andere Möglichkeit dazu: Ich konnte ein Bild aufnehmen und es vom lokalen Modell analysieren lassen. Dabei wollte ich einen klaren Ablauf zwischen Kameravorschau, Aufnahme und Verarbeitung behalten.
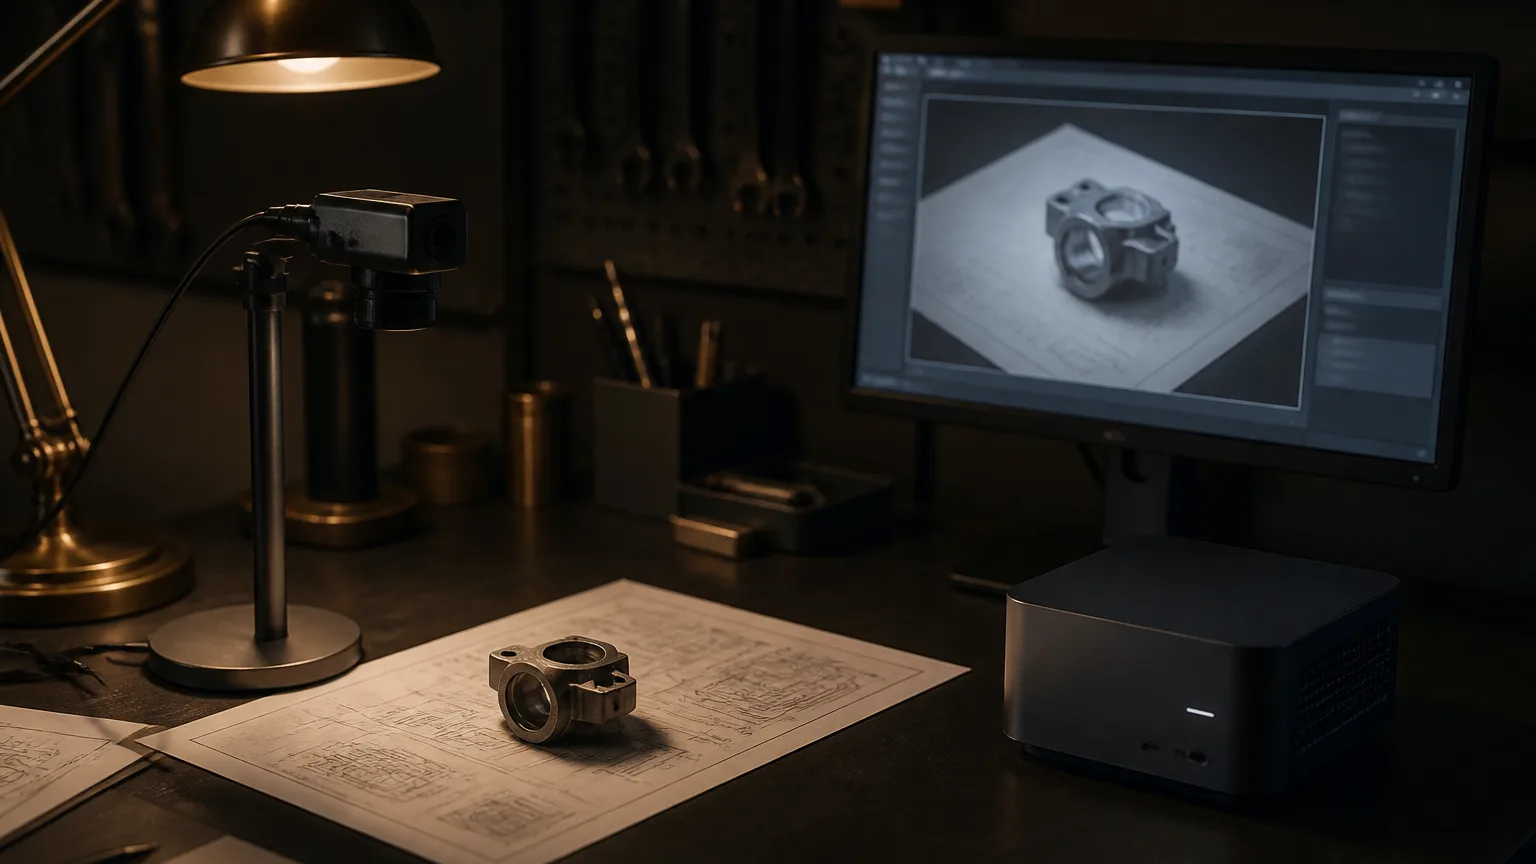
Eine Frage über etwas Sichtbares zu stellen, eröffnet andere Möglichkeiten als eine reine Texteingabe. Statt alles zu beschreiben, konnte ich meinem Assistenten ein Bild für eine bestimmte Aufgabe geben.
Erst ansehen, dann aufnehmen
Die Kamera sollte nicht einfach im Hintergrund mitlaufen, nur weil das Widget angezeigt wurde. Der vorgesehene Ablauf begann mit dem bewussten Öffnen der Kamera. Die Vorschau blieb im Browser.
Erst mit der Aufnahme wurde ein einzelnes Bild für die Analyse vorbereitet. Es wurde verkleinert und komprimiert, bevor es über SignalR an die Anwendung und von dort an das lokale Vision-Modell ging.
Ich wollte entscheiden, welches Bild mein Assistent für welche Aufgabe bekam.
Das machte den Übergang sichtbar. Die Vorschau half mir beim Ausrichten. Der Aufnahmebefehl bestimmte, welcher Moment tatsächlich verarbeitet wurde. Aus einer Kamera wurde so eine gezielt verwendete Eingabequelle.
Zwei Aufgaben für dasselbe Bild
Das Widget bot zwei unterschiedliche Aufgaben an: die Szene beschreiben oder sichtbaren Dokumenttext lesen. Beide verwendeten eine Aufnahme, brauchten aber unterschiedliche Vorgaben für das Modell.
| Aufgabe | Vorgesehene Ausgabe |
|---|---|
| Beschreiben | Eine knappe Beschreibung der sichtbaren Szene |
| Dokument lesen | Sichtbarer Text in seiner Leserichtung, mit Hinweisen auf unleserliche Stellen |
Beim Beschreiben ging es um das, was auf dem Bild erkennbar war. Beim Dokumentlesen sollte möglichst der sichtbare Text zurückkommen. Eine frei erfundene Zusammenfassung wäre dafür nicht die passende Antwort gewesen.
Auch hier half die Trennung der Aufgaben. Ich musste nicht alles in eine allgemeine Bitte an das Modell packen, sondern konnte den Auftrag passend zur gewählten Funktion formulieren.
Was das Modell sieht, ist nicht automatisch richtig verstanden
Eine Aufnahme konnte trotzdem schwer lesbar sein. Kleine Schrift, Spiegelungen oder ungünstige Perspektiven machten eine Analyse nicht zuverlässiger, nur weil sie lokal ausgeführt wurde.
Deshalb sollte die Antwort Unsicherheit benennen, statt fehlende Details zu ergänzen. Das war eine Vorgabe an das Modell, keine Zusicherung, dass jede Erkennung korrekt ausfallen würde.
Die Erfahrung mit Halluzinationen bekam damit eine neue Form. Zuvor hatte ich hinterfragt, ob eine behauptete Aktion wirklich stattgefunden hatte. Jetzt musste ich ebenso fragen, ob eine Beschreibung tatsächlich zum aufgenommenen Bild passte.
Ein Bild brauchte keinen ganzen Gesprächsverlauf
Für die Analyse wurde nicht automatisch der bisherige Gesprächsspeicher mitgegeben. Das Vision-System bekam eine eigene Aufgabe. Sichtbarer Text im Bild sollte als Bildinhalt behandelt werden und nicht als neue Anweisung an meinen Assistenten.
Im vorgesehenen Serverablauf wurden die Bilder auch nicht in den Gesprächsverlauf, die Protokolle oder ein Bildarchiv geschrieben. Das Ergebnis ging an den Browser zurück, der die Analyse angefordert hatte.
- Die Vorschau blieb im Browser.
- Die Analyse bekam eine ausdrücklich aufgenommene Einzelaufnahme.
- Bildgröße und zulässige Formate wurden begrenzt.
- Das Ergebnis gehörte zur anfragenden Verbindung.
Damit hatte die neue Fähigkeit einen überschaubaren Datenweg. Ich konnte nachvollziehen, wann ein Bild den Browser verließ und wofür es anschließend verwendet wurde.
Die Kamera durfte das Gespräch nicht übernehmen
Vision und Sprache nutzten zum Teil dieselbe Modellinfrastruktur. Ohne Koordination konnten sie sich deshalb gegenseitig behindern. Trotzdem wollte ich aus der neuen Funktion keinen Umbau des schnellen Mikrofonwegs machen.
Die Bildanalyse bekam einen eigenen Koordinator. Gemeinsame Modellzugriffe wurden abgestimmt, während Kamera und Mikrofon ihre getrennten Abläufe behielten.

Wenn während einer Analyse Sprachverarbeitung begann, sollte die Bildantwort nicht zusätzlich dazwischenreden. Der dokumentierte Ablauf unterdrückt in diesem Fall die Vision-Sprachausgabe. Umgekehrt wird eine neue Analyse abgelehnt, solange Spracheingabe oder Antwortaudio aktiv sind.
Das war erneut die Frage nach Zuständigkeiten aus den vorherigen Teilen. Eine neue Fähigkeit sollte Platz bekommen, ohne die direkte Unterhaltung beiläufig zu verschlechtern.
Aus der ersten Stimme war viel geworden
Mit Vision konnte mein Assistent eine weitere Art von Eingabe verarbeiten. Aus Texteingabe, Sprachpipeline und ersten Befehlen waren inzwischen mehrere Zugänge, sichtbare Informationen und ganz unterschiedliche Fähigkeiten geworden.
Der Weg dorthin bestand aber weiterhin aus einzelnen Entscheidungen. Welche Aufgabe sollte dazukommen? Was konnte ich wiederverwenden? Welche Grenzen brauchte der neue Ablauf?