Vom Jugendtraum zum eigenen Gesprächspartner: meine persönlichen Erfahrungen mit einem lokalen KI-Assistenten, seinen ersten Worten, langen Pausen und den nächsten Schritten.
Schon als Jugendlicher wollte ich mit meinem Computer sprechen können. Viele Jahre später saß ich vor einer selbst gebauten Anwendung und hörte tatsächlich die ersten Worte aus den Lautsprechern. Ich verstand kein einziges davon. Trotzdem war es ein großartiger Moment.
Die ersten Worte aus meinen Lautsprechern waren ein großartiger Moment. Danach fiel mir auf, wie lange ich auf sie gewartet hatte. Mein Assistent konnte sprechen. Für ein Gespräch war er allerdings noch viel zu langsam.
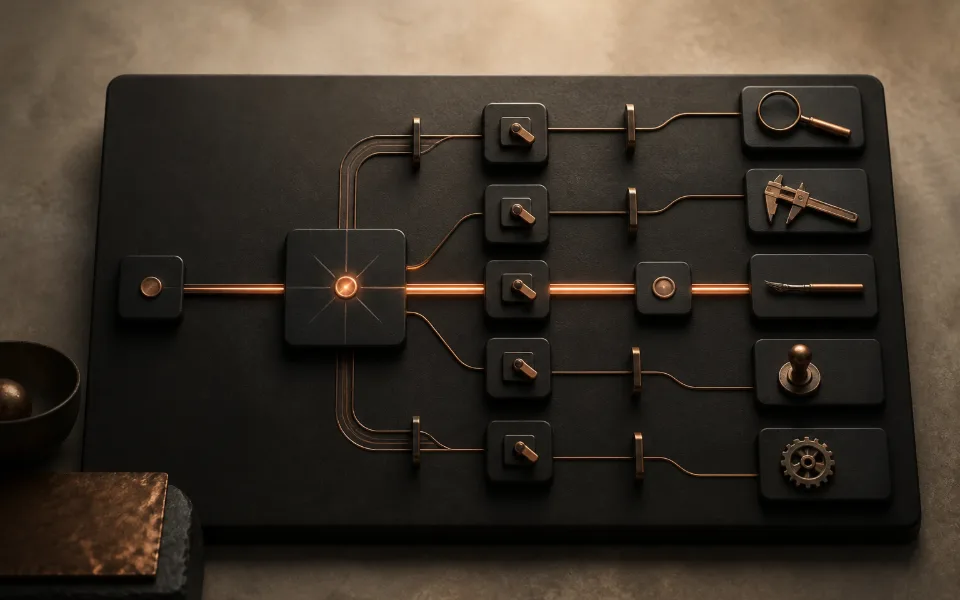
Mein Assistent konnte inzwischen zuhören und sprechen. Jetzt wollte ich mit meiner Stimme auch etwas auslösen. Aus den ersten einfachen Befehlen wurde eine Intent-Pipeline, die mit jeder Idee weiterwuchs. Dabei musste ich mir immer wieder überlegen, wie viel Freiheit ich meinem Assistenten eigentlich geben wollte.
Mit dem Skillsystem bekam mein Assistent neue Fähigkeiten. Musik steuern, im Internet suchen, das Wetter abrufen: Vieles davon war genau das, was ich mir gewünscht hatte. Gleichzeitig entfernte ich mich damit von meiner ursprünglichen Vorstellung einer rein lokalen Anwendung. Ich musste entscheiden, wo mein Assistent meine Zustimmung brauchte. Und ich lernte, dass eine überzeugende Antwort noch lange kein Beleg für eine ausgeführte Aktion war.
Mein Assistent behauptete manchmal, Dinge erledigt zu haben, die nie passiert waren. Ich wollte mich auf seine Antworten verlassen können. Also begann ich, ihm genauer zu erklären, was er war, welchen Zweck er erfüllen sollte und welche Grenzen er einhalten musste. Dabei bekam er auch etwas, das ich seine „Persönlichkeit“ nannte.
Nach der Pause stand die Entscheidung: Mein Assistent sollte eine Webanwendung bekommen. Die Frage war, wie viel von meiner bisherigen Arbeit dafür übrig bleiben würde. Musste ich neu anfangen? Oder konnte ich auf dem aufbauen, was bereits funktionierte?
Die Webanwendung gab meinem Assistenten ein Gesicht. Damit konnte ich Informationen anders darstellen als bisher. Wetter, Uhrzeit und Zustände mussten nicht mehr nur als Text durch die Konsole laufen oder kurz in einer gesprochenen Antwort vorkommen. Sie konnten einen eigenen Platz bekommen.
Mit den Widgets konnten Informationen sichtbar bleiben. Aber damit war noch nicht geklärt, was mein Assistent behalten sollte. Ein Gespräch fortzusetzen, mich später an etwas zu erinnern und mir einen Überblick über den Tag zu geben, waren unterschiedliche Aufgaben. Ich musste ihnen jeweils einen eigenen Platz geben.
Die ersten Widgets hatten gezeigt, wie praktisch sichtbare Informationen sein konnten. Mit Nachrichten, Aktien und Krypto kamen weitere Quellen dazu. Aus einzelnen Anzeigen entwickelte sich der Signal Desk. Dabei musste ich darauf achten, was die Daten tatsächlich aussagten – und was das Sprachmodell daraus machen durfte.
Mein Assistent hatte inzwischen eine Weboberfläche, Widgets und einen Signal Desk. Der nächste Zugang musste nicht noch mehr auf dem Bildschirm zeigen. Mit Telegram konnte eine Nachricht vom Telefon aus denselben Assistenten erreichen. Damit kam aber auch eine neue Frage dazu: Wer durfte ihm auf diesem Weg überhaupt Aufträge geben?
In Teil 2 hatte ich die langen Pausen meines Assistenten mit Streaming und einem vorbereiteten Whisper-Server verkürzt. Mit der Weboberfläche kamen weitere Schritte hinzu. Ein schneller Modellaufruf allein sagte mir jetzt noch weniger darüber, wann ich die Antwort tatsächlich hören würde.
Mein Assistent bekam immer mehr Fähigkeiten. Aber eine Funktion einmal erfolgreich vorzuführen war etwas anderes, als sie regelmäßig benutzen zu können. Nach einem Abbruch, einem Neustart oder einer verlorenen Verbindung musste die Anwendung wieder in einen brauchbaren Zustand kommen. Damit bekam die Arbeit zwischen den sichtbaren Funktionen mehr Gewicht.