PROJEKTEINBLICK ·
Ein Scan ist noch lange kein Text
Ein eingescannter Brief sieht lesbar aus und enthält für eine Suchmaschine doch kein einziges Wort. Erst die Texterkennung macht mein Archiv durchsuchbar.
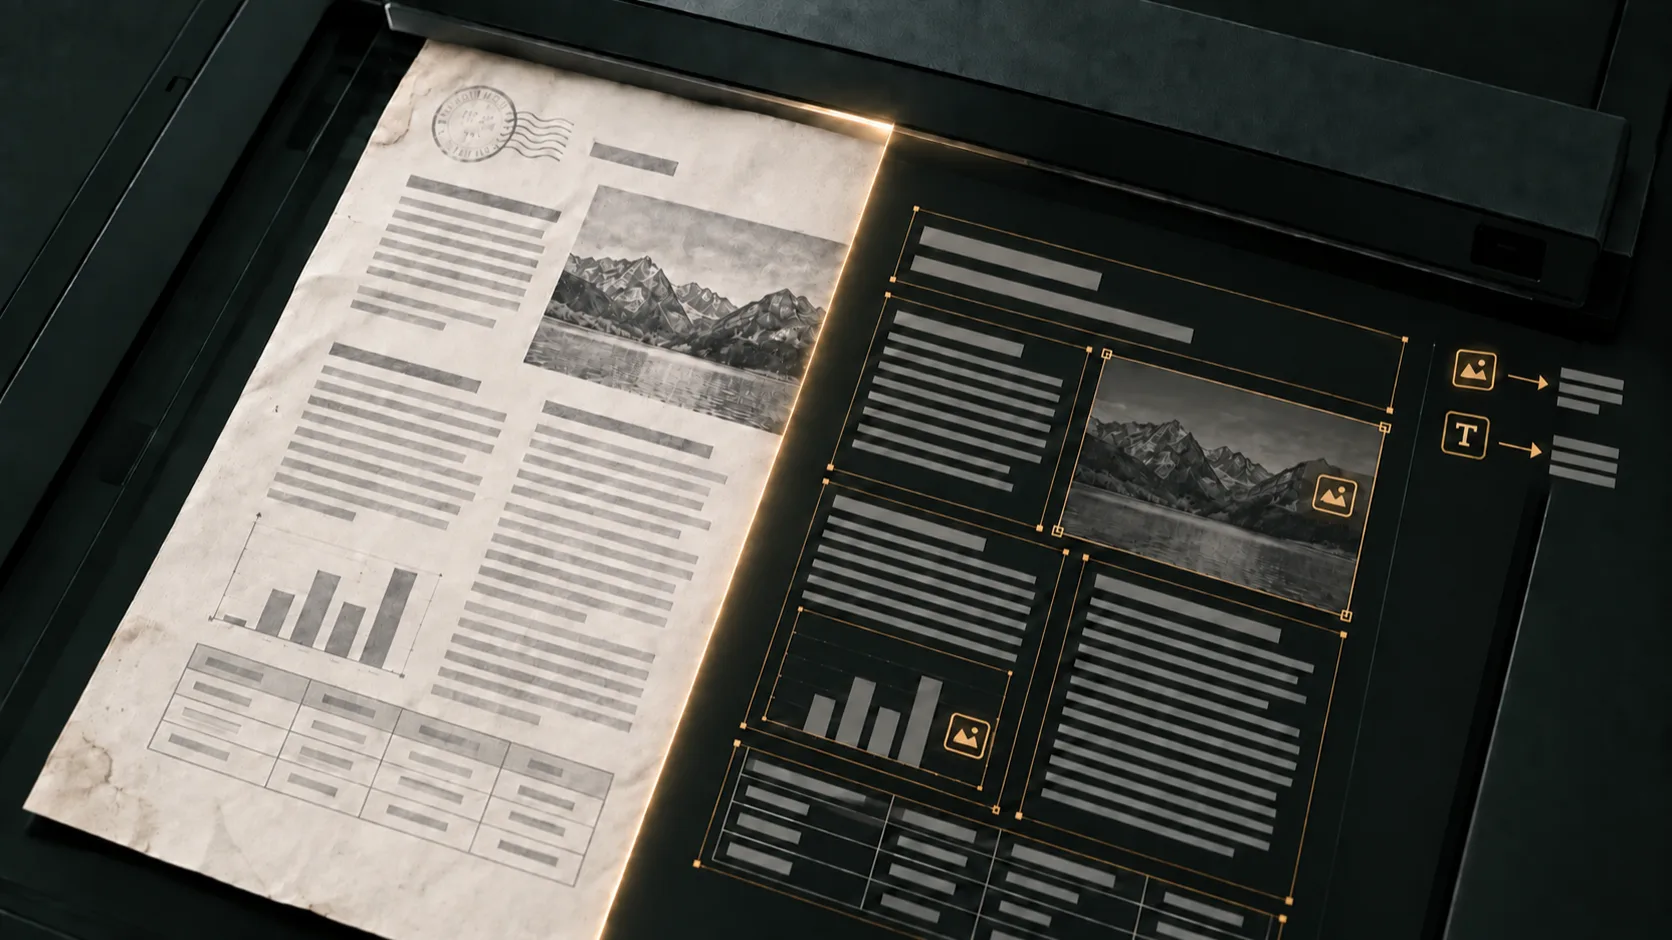
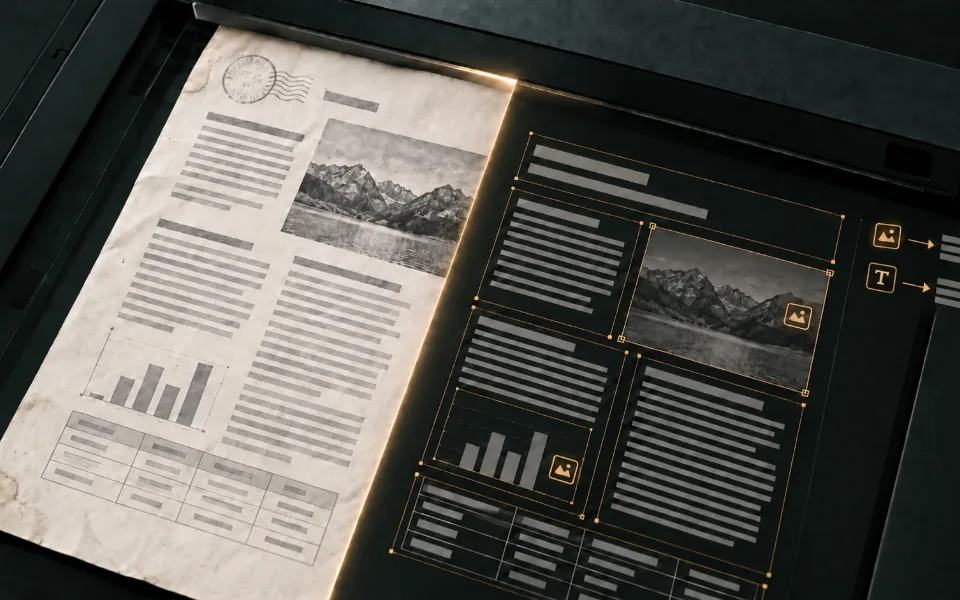
Ein eingescannter Brief sieht auf dem Bildschirm vollkommen lesbar aus. Ich erkenne den Briefkopf, das Datum, den Betrag. Für eine Suchmaschine enthält dieselbe PDF aber möglicherweise kein einziges Wort. Sie sieht nur ein Bild der Seite. Und weil mein Archiv fast vollständig aus eingescannter Post besteht, war das nicht irgendein Randproblem, sondern die zentrale Aufgabe.
Rund 90 Prozent meines Archivs sind reine Scans ohne jede Textebene. Ohne Texterkennung wären sie für die Suche schlicht nicht vorhanden.
Zwei PDFs, die gleich aussehen
Manche PDFs enthalten echten Text. Das gilt etwa für Rechnungen, die ein Programm erzeugt und per E-Mail verschickt hat. Operus Search kann die Wörter darin direkt auslesen. Ein gescannter Brief dagegen besteht nur aus Bildern. Und manchmal steckt beides in einer Datei: Die erste Seite enthält Text, die zweite ist ein nachträglich eingescannter Anhang.
Operus Search geht deshalb Seite für Seite vor. Wo Text vorhanden ist, wird er übernommen. Wo eine Seite leer bliebe, kommt die Texterkennung zum Einsatz – auf Englisch OCR, Optical Character Recognition. So muss nicht jede Datei durch denselben aufwendigen Prozess.
Dafür werden die Seiten mit Ghostscript in Bilder umgewandelt und anschließend von Tesseract gelesen, einem bewährten Open-Source-Programm zur Texterkennung. Beides läuft auf meinen eigenen Geräten. Kein Brief geht dafür an einen Online-Dienst.
Die Texterkennung ist kein Zusatz für ein paar alte Scans. Sie entscheidet, ob der größte Teil meines Archivs für Suche und KI überhaupt existiert.
Echte Post ist nicht sauber
Ein gerader, sauber gedruckter Brief ist für die Texterkennung vergleichsweise einfach. Im echten Archiv kommt aber einiges zusammen: Seiten, die schief durch den Einzug gelaufen sind, blasser Druck, graues Recyclingpapier, Stempel und Unterschriften mitten im Text, Tabellen in Abrechnungen und Briefköpfe mit Logos und mehreren Spalten.
Bevor Tesseract eine Seite liest, bereitet Operus Search sie deshalb vor:
- die Seite richtig herum drehen;
- in Graustufen umwandeln;
- schiefe Seiten gerade ausrichten;
- ungleichmäßige Helligkeit ausgleichen;
- sehr kleine Vorlagen vergrößern;
- die Seite in Bereiche aufteilen lassen, statt sie als eine einzige Textfläche zu behandeln.
Diese Einstellungen habe ich nicht nach Gefühl gewählt, sondern an Testdokumenten gemessen. Der letzte Punkt brachte dabei am meisten: Wenn Tesseract das Layout einer Seite selbst erkennt, also Briefkopf, Adressfeld und Spalten auseinanderhält, wird der erkannte Text deutlich besser. Eine höhere Auflösung beim Umwandeln brachte dagegen keine Verbesserung – sie kostete nur Zeit.
Ein falsches Zeichen wandert durch das ganze System
Mit der Erkennung selbst ist es nicht getan. Auch der Weg des erkannten Texts zurück ins Programm muss stimmen. Unter Windows kam zeitweise aus einem Eurozeichen oder einem Umlaut eine sinnlose Zeichenfolge an – nicht weil Tesseract falsch gelesen hätte, sondern weil die Ausgabe in der falschen Zeichenkodierung eingelesen wurde.
Das ist tückisch, weil sich der Fehler danach überall festsetzt:
falsch eingelesener Text
            ↓
       Suchindex
            ↓
  Textabschnitte für die KI
            ↓
   Suche nach Bedeutung
            ↓
Antwort der KIIn der Vorschau sieht der Brief dann völlig normal aus, während Suche und KI mit beschädigtem Text arbeiten. Eine Suche nach „Gebühr“ findet ihn nicht mehr, ein Betrag in Euro wird nicht erkannt. Heute liest Operus Search die Ausgabe ausdrücklich in der richtigen Kodierung, und automatische Tests sorgen dafür, dass das so bleibt.
Nicht alles ist eine PDF
Auch wenn der Kern meines Archivs aus Scans besteht, liegen in den Ordnern noch andere Dateien. Operus Search kann deshalb mehr als PDFs lesen:
| Art | Beispiele |
|---|---|
| gescannte Briefe, digitale Rechnungen, Formulare, E-Rechnungen | |
| Office | Word, Excel und PowerPoint, auch ältere Formate |
| OpenDocument | Dateien aus LibreOffice |
| Text | einfache Textdateien, Markdown, CSV, HTML und RTF |
| gespeicherte E-Mails samt unterstützter Anhänge | |
| Bilder | JPEG, PNG, TIFF und BMP über die Texterkennung |
Auch bei einfachen Textdateien rät Operus Search die Kodierung nicht einfach. Es prüft, ob die Datei sauber im heute üblichen Format vorliegt, und weicht nur bei eindeutig fehlerhaften Zeichen auf das ältere Windows-Format aus. Solche unscheinbaren Entscheidungen verhindern, dass sich über Jahre unbemerkt kaputter Text im Index ansammelt.
Der erkannte Text lässt sich erneuern
Zu jedem Dokument merkt sich Operus Search, mit welchen Einstellungen es gelesen wurde – etwa mit welchen Sprachen die Texterkennung gearbeitet hat. Ändere ich eine dieser Einstellungen, werden genau die betroffenen Dokumente neu verarbeitet. Eine Word-Datei muss nicht neu gelesen werden, nur weil sich etwas an der Texterkennung geändert hat. Ein gescannter Brief schon.
Damit wurde aus den Bildern meines Archivs endlich ein verlässlicher Textbestand. Jetzt konnte die eigentliche Suche zeigen, was sie kann. Und mir war wichtig, dass sie das auch dann tut, wenn gar kein Sprachmodell läuft.