PROJEKTEINBLICK ·
Meine Dokumente sollten bei mir bleiben
Versicherungsscheine, Verträge, Steuerbescheide: Durchsuchbar sollten sie werden, aber mein Netz nicht verlassen. Das war die erste Entscheidung.
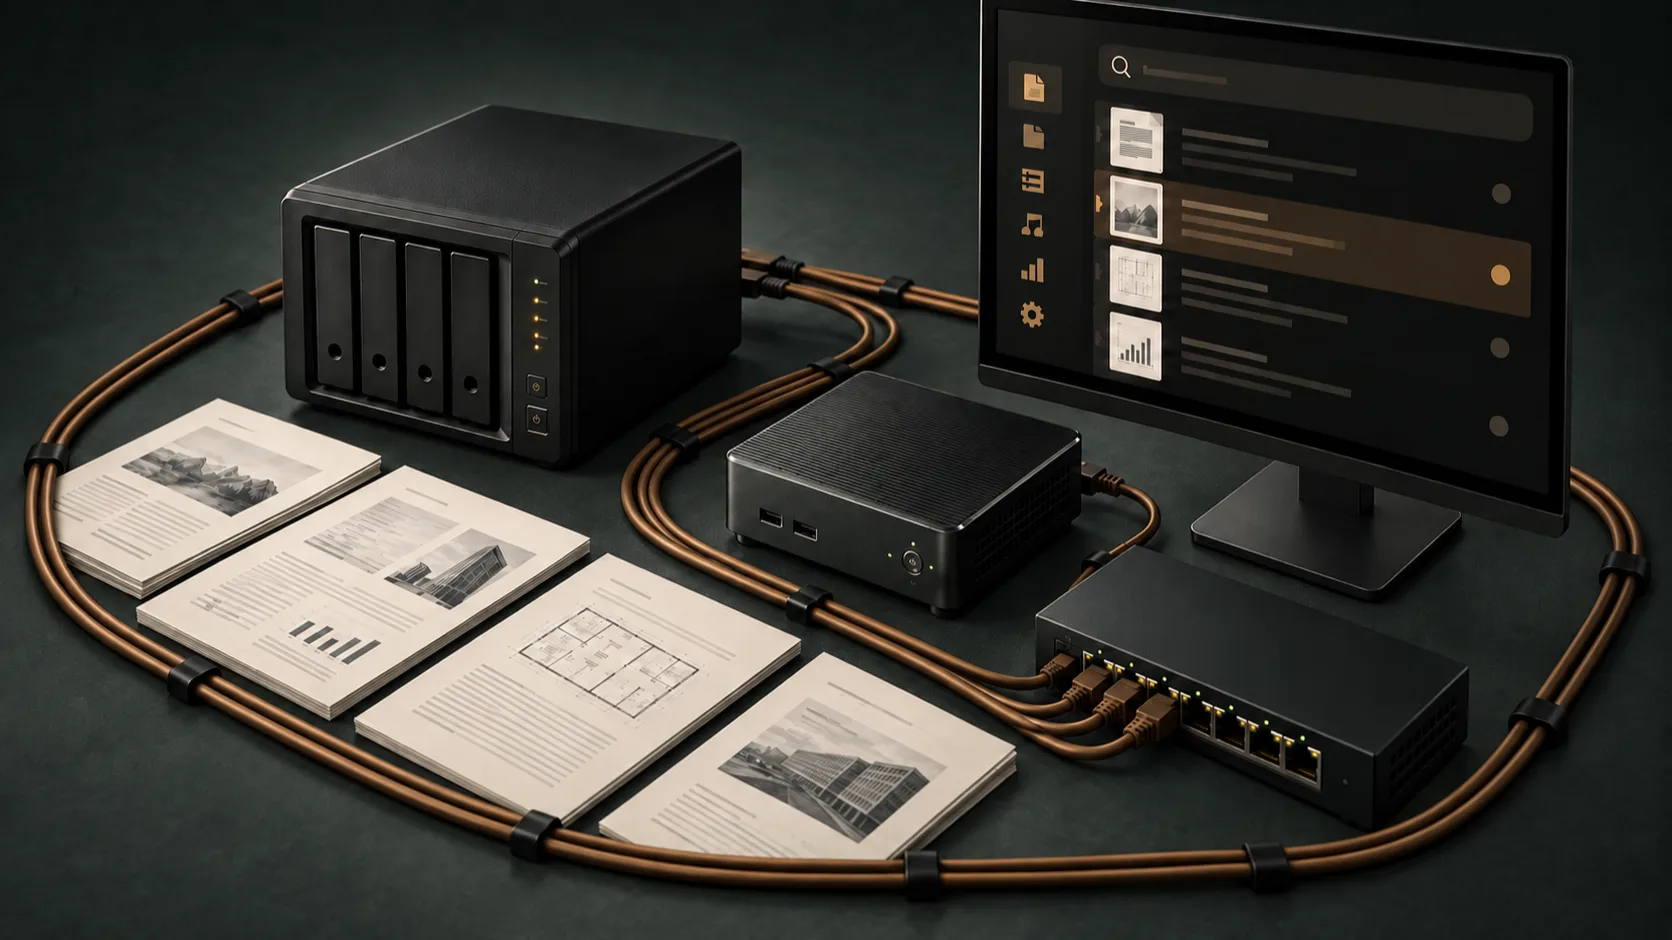
Wer meine eingescannte Post durchsucht, erfährt sehr viel über mich. Rechnungen zeigen, was ich kaufe und was es kostet. Verträge enthalten Adressen, Laufzeiten und Kontonummern. Versicherungsschreiben, Steuerbescheide und Briefe von Behörden sind noch deutlich persönlicher. Bevor ich die erste Zeile Suchcode geschrieben habe, stand deshalb fest: Bequemer zu suchen darf nicht heißen, dieses Archiv aus der Hand zu geben.
Lokal von Anfang an
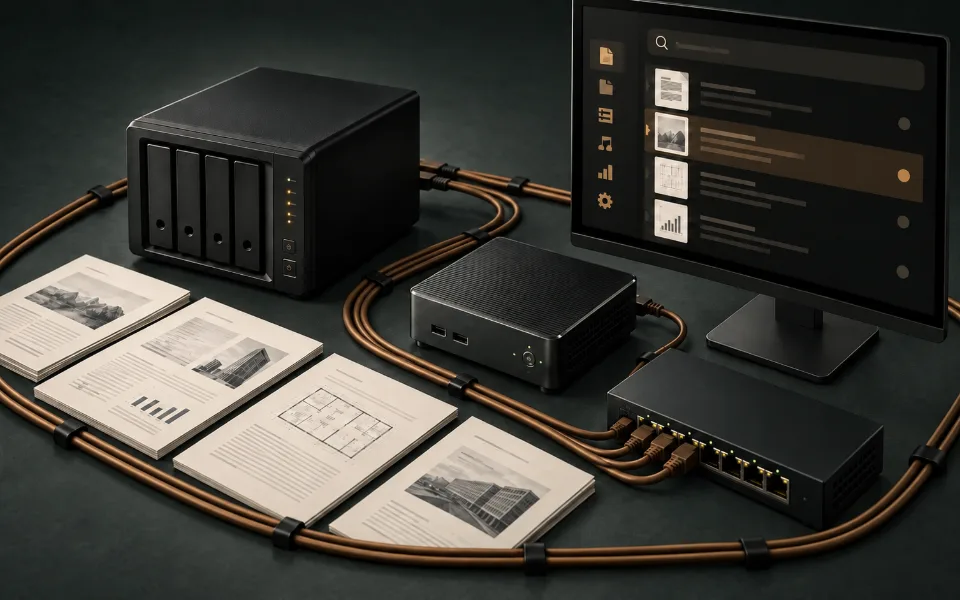
Operus Search läuft bei mir zu Hause – auf meinem Rechner oder auf meinem Server im Keller. Die Briefe bleiben dort, wo sie schon immer lagen: auf der Festplatte und auf dem NAS. Datenbank und Suchindex liegen daneben im lokalen Datenverzeichnis. Auch die Texterkennung läuft auf meinen eigenen Geräten.
Kommt ein Sprachmodell ins Spiel, läuft auch das lokal – über Ollama, eine Software, die KI-Modelle auf eigener Hardware im Heimnetz ausführt. Keine Frage und kein Dokumentinhalt geht dafür an einen Anbieter im Internet.
Das ist kein Schalter, den ich am Ende ergänzt habe. Es hat jede weitere Entscheidung geprägt.
Meine Suche darf mehr über meine Dokumente wissen – ohne dass ein fremder Dienst mehr über mich erfährt.
Ein Programm statt einer Plattform
Ich habe mich bewusst gegen eine Architektur aus vielen kleinen Diensten entschieden, wie man sie aus großen Cloud-Anwendungen kennt. Operus Search ist ein einziges Programm mit klar getrennten Bereichen im Inneren – ohne eigene Server für jede Aufgabe, ohne Warteschlangensysteme und ohne Cluster.
| Baustein | Aufgabe | Wo er läuft |
|---|---|---|
| ASP.NET Core | Programmkern, Oberfläche und Hintergrundarbeit | eigener Rechner oder Server |
| SQLite | Dokumente, Suchindex und Aufträge in einer Datei | lokales Datenverzeichnis |
| Tesseract und Ghostscript | Texterkennung für Scans | eigener Rechner oder Server |
| Ollama | optionale KI-Funktionen | eigene Hardware im Heimnetz |
| Browseroberfläche | Suchen, Fragen, Quellen ansehen | vom eigenen Programm ausgeliefert |
Für ein persönliches Werkzeug ist diese Einfachheit ein Vorteil. Ein einzelnes Programm kann ich verstehen, sichern und betreiben, ohne nebenher ein kleines Rechenzentrum zu pflegen.
Es lässt sich außerdem leicht umziehen. Für später ist geplant, Operus Search in einem Docker-Container auf einen NVIDIA DGX Spark zu verlagern – einen kompakten KI-Rechner, auf dem auch größere Sprachmodelle schnell laufen. Am Prinzip ändert das nichts: Auch dieses Gerät steht bei mir, und die Daten verlassen mein Netz nicht.
Und wenn das Sprachmodell einmal nicht läuft, bleibt das Archiv trotzdem durchsuchbar. Warum mir das so wichtig war, erzähle ich in Teil 5.
Kein Weg nach draußen
„Lokal“ ist schnell behauptet. Bei Operus Search ist es eine Frage des Codes: Das Programm enthält keinen Code, der von sich aus mit Diensten im Internet spricht.
Die einzige Verbindung, die es überhaupt aufbaut, führt zu Ollama. Sie geht nur an die Adresse, die ich selbst eingetragen habe, und diese Adresse wird vor jedem Aufruf geprüft:
- der eigene Rechner ist erlaubt;
- Geräte im Heimnetz, etwa der Server im Keller, sind erlaubt;
- Ziele im Internet werden blockiert, solange ich sie nicht ausdrücklich freigebe;
- eine ungültige Adresse wird gar nicht erst angesprochen.
Diese ausdrückliche Freigabe gibt es aus einem bestimmten Grund. Ollama bietet auch Modelle in der Cloud an, die deutlich größer und stärker sind als alles, was zu Hause läuft. Operus Search könnte sie nutzen, wenn ich das bewusst einschalte. Aktuell mache ich das nicht. Meine Fragen und Briefe bleiben im eigenen Netz.
Auch die Oberfläche lädt keine fremden Schriften, Skripte oder Zähldienste. Es gibt keine Telemetrie, keinen automatischen Fehlerbericht und keine heimliche Suche nach Updates. Meine Fragen und Dokumentinhalte landen auch nicht in den Protokolldateien.
Frage ich Operus Search nach dem Wetter von morgen, bekomme ich deshalb keine Vorhersage. Es gibt im Programm keinen Weg ins Internet, über den es sie holen könnte.
Grenzen, die ich kenne
Zu einem ehrlichen Local-first-Versprechen gehört auch, was es nicht leistet:
- In den Protokolldateien dürfen Dateipfade stehen. Aus einem Pfad wie „Versicherungen/Hausrat“ lässt sich durchaus etwas ablesen.
- Die Datenbank enthält den erkannten Text aller Briefe. Sie ist damit genauso schützenswert wie die Originale und gehört in dieselbe Sicherung.
- Wer Operus Search aus dem Heimnetz von einem anderen Gerät aus nutzen will, braucht einen Zugangsschlüssel. Führt der Weg über ein unsicheres Netz, kommt eine verschlüsselte Verbindung davor.
Diese Grenzen machen das Konzept nicht schwächer. Sie verhindern, dass „lokal“ zu einem Zauberwort wird. Ich weiß, welche Daten wo liegen, welcher Teil des Programms eine Verbindung aufbaut und welche Entscheidungen ich selbst treffen muss.
Damit stand die Grenze, innerhalb der alles Weitere passieren sollte. Nun musste aus den vielen Dateien auf Rechner und NAS ein Suchindex werden, der neue Briefe mitbekommt, Ausfälle verkraftet und nach einem Neustart nicht wieder bei null anfängt.