PROJEKTEINBLICK ·
Deutsche Sprachausgabe in KI-Videos: Wenn der Akzent nicht stimmt
Lizzy sollte auf Deutsch rappen, klang aber überraschend französisch. Warum selbst genaue Ausspracheanweisungen keine Garantie sind – und wann ein Fehler zum Charaktermerkmal werden darf.
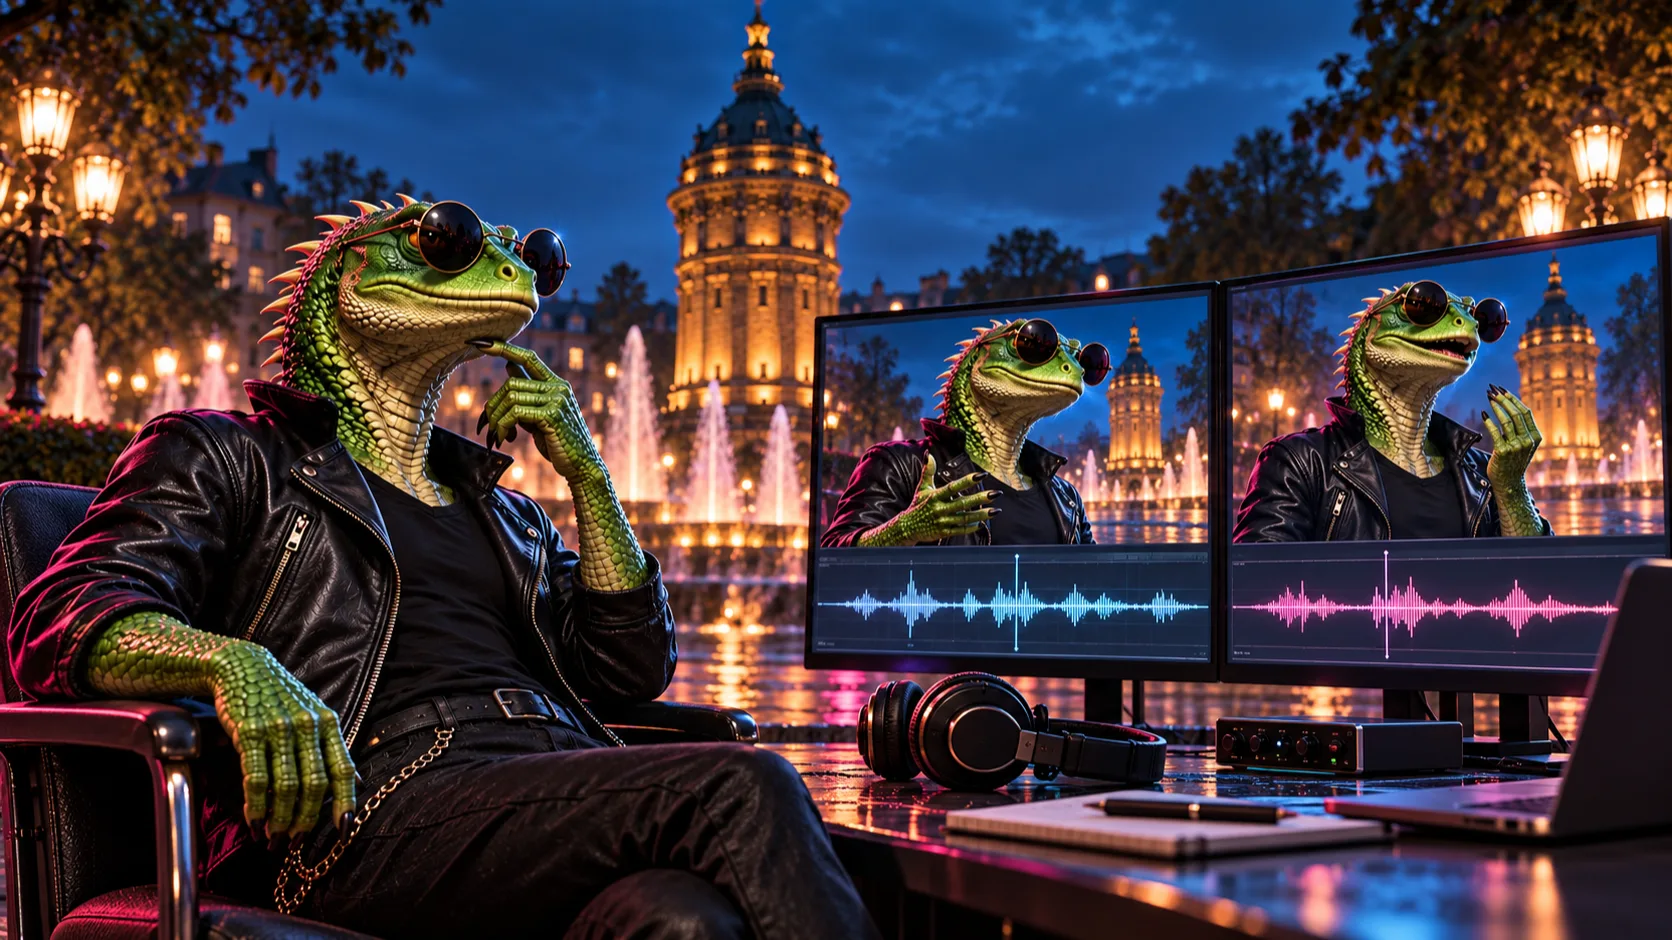
Native Stimmen machen Video-KI besonders reizvoll: Eine Figur kann sprechen oder singen, ohne dass Sprache, Lippenbewegung und Musik später getrennt zusammengesetzt werden müssen. Beim ersten Rap mit meinem grünen Lizard zeigte sich aber auch, wie wenig exakt sich Aussprache und Akzent dabei steuern lassen.
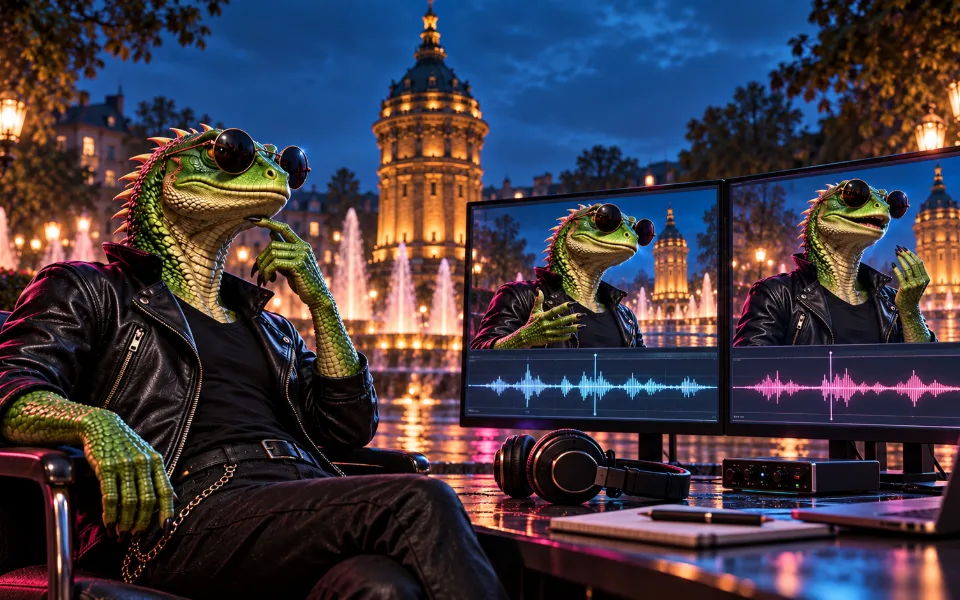
Lizzy sollte mit klarem Deutsch und Mannheimer Straßencharakter rappen. Heraus kam eine Stimme mit einem hörbaren französischen Akzent. Der war nicht vorgesehen – und wurde trotzdem vorerst Teil der Figur.
Ein deutscher Rap mit unerwartetem Akzent
Für den ersten Clip bekam Seedance 2.0 Mini ein fertiges Startbild und einen vollständig ausformulierten Text. Der Lizard sollte sofort losrappen, jedes deutsche Wort deutlich aussprechen und sich passend zum Beat bewegen. Bild, Bewegung, Lippen und Musik funktionierten mit nur einer Generierung erstaunlich gut.
Transkript
Ein grüner Lizard mit runder Sonnenbrille und schwarzer Lederjacke rappt in einer neonbeleuchteten Gasse direkt in die Kamera. Die deutsche Rap-Stimme besitzt einen hörbaren französischen Akzent.
Gerade die Stimme wich jedoch von der Vorgabe ab. Statt eines klaren deutschen Raps mit Mannheimer Färbung klang Lizzy überraschend französisch. Das ist kein Fehler, den man in einem einzelnen Frame markieren könnte. Er entsteht aus dem Zusammenspiel von Stimme, Rhythmus, Betonung und Aussprache.
Animate the exact green lizard character from the supplied start image.
He performs an energetic, catchy German rap directly to camera in the same neon-lit alley.
Start rapping immediately in the first second: no intro and no silence.

Natural expressive mouth shapes tightly synchronized to every German syllable,
confident rhythmic head bobs, subtle shoulder groove and controlled hand gestures
while the camera makes a gentle rhythmic push-in.

Keep the face, green scales, round sunglasses, black leather jacket, body proportions,
alley, cyan-magenta lighting and overall identity fully consistent.

Masculine playful German rap voice with Mannheim street character,
clear diction, punchy modern hip-hop beat beneath the vocal, lyrics fully audible.

Perform exactly this original lyric once:
“Monnem, mein Viertel, meine Stadt — Neon auf den Schuppen, jede Nacht bin ich am Start.
Vom Wasserturm zum Neckar, dieser Beat hält uns wach — grüner Style, Monnem-Vibe,
und die ganze Straße lacht!”

End on a charismatic grin and small sunglasses adjustment that can loop smoothly into the opening pose.
Vertical Instagram Reel, strong subject contrast, no on-screen text, no subtitles,
no logos, no watermark, no extra limbs, no deformed claws, no duplicate tail, no camera cuts.Warum ich den Akzent vorerst akzeptiert habe
Bei einem Nachrichtensprecher, einer realen Person oder einem Erklärvideo wäre der Akzent für mich ein Grund zur Korrektur gewesen. Bei Lizzy wirkte die Abweichung anders. Die grüne Echse mit Sonnenbrille und Lederjacke war ohnehin eine überzeichnete Kunstfigur. Die unerwartete Stimme passte auf eine merkwürdige, aber sympathische Weise zu ihrem Auftritt.
Deshalb habe ich den ersten Clip nicht verworfen. Für Lizzy war die Abweichung vorerst kein Ausschlussgrund. Sie wurde weniger zu einem Fehler als zu einem Teil seines Charakters. Das Wort „vorerst“ ist dabei wichtig: Eine charmante Eigenheit in einem kurzen Rap ist noch kein Beweis dafür, dass dieselbe Aussprache in jeder späteren Geschichte funktionieren würde.
Ein zweiter Versuch mit phonetischer Regie
Beim nächsten Clip wollte ich wissen, ob sich die Aussprache präziser führen lässt. Diesmal erklärte der Prompt nicht nur die Bedeutung von „Monnem“. Er zerlegte das Wort in zwei deutsche Silben, ergänzte eine ungefähre Lautschrift und schloss eine französisch klingende Variante ausdrücklich aus.
Transkript
Der grüne Lizard Lizzy rappt vor dem Mannheimer Wasserturm und erklärt, dass „Monnem“ Mannheim bedeutet. Trotz genauer phonetischer Vorgaben bleibt seine Aussprache an einzelnen Stellen eigenwillig.
Animate the exact green lizard character from the supplied Mannheim water-tower start image
into a polished 15-second vertical German rap Reel.
He begins rapping immediately in the first second, directly to camera, with no intro and no silence.

Use a natural confident male voice from Germany with subtle Mannheim/Kurpfalz character.
Critical pronunciation: say “Monnem” clearly as two German syllables “MON-nem”
(IPA approximately /ˈmɔnəm/), never French-sounding, never “Mon-nème”.
Clear German diction, relaxed rhythmic flow, punchy modern hip-hop beat underneath,
every word fully audible.

Perform exactly this original lyric once and do not add words:
“Du fragst: Was heißt Monnem? Klar, Mannheim ist gemeint.
Zwischen Neckar, Rhein und Quadraten, wo die ganze City scheint.
Wasserturm im Rücken, Kurpfalz tief im Herz.
Monnem sagt man hier zur Heimat – laut und ehrlich, ohne Scherz.”

Natural expressive mouth shapes tightly synchronized to every syllable,
confident head bobs, subtle shoulder groove and controlled open-hand rap gestures.
Make a slow cinematic push-in from the initial low-angle medium-full framing toward a medium close-up.

Keep the same face, emerald scales, small head spines, round sunglasses, black leather jacket,
black clothes, natural hands and claws, tail, body proportions, illuminated water-tower fountain setting,
wet pavement and blue-gold-magenta lighting fully consistent.

End with a proud grin and a small gesture toward the tower, then settle into a pose suitable for a smooth loop.
No camera cuts, no on-screen text, no subtitles, no logos, no watermark, no extra people,
no extra limbs, no malformed or duplicated fingers, no duplicate tail, no warped sunglasses,
no distorted tower, no sudden background changes.Die Anweisung war erheblich genauer. Sie führte aber nicht zu der kontrollierten Aussprache, die man von einem menschlichen Sprecher nach einer klaren Regieanweisung erwarten würde. Auch diese Fassung klang an einzelnen Stellen eigenwillig. Weil Bild, Rhythmus und Gesamtwirkung stimmten, habe ich sie nach vollständigem Anhören ebenfalls akzeptiert.
Aussprache ist mehr als geschriebener Text
Ein Sprachmodell muss hier mehrere Aufgaben gleichzeitig lösen: eine passende Stimme wählen, den Text rhythmisch in 15 Sekunden unterbringen, Musik erzeugen, Lippenbewegungen synchronisieren und eine Figur visuell stabil halten. Dabei ist ein Wort im Prompt keine unveränderliche Tonaufnahme. Auch Hinweise wie Lautschrift, Silbentrennung und „kein französischer Akzent“ erhöhen nur die Wahrscheinlichkeit des gewünschten Ergebnisses.
| Fassung | Sprachliche Vorgabe | Kosten | Ergebnis |
|---|---|---|---|
| Erster Lizzy-Rap | Klare deutsche Aussprache mit Mannheimer Straßencharakter | 10 Credits | Französischer Akzent, für die Figur akzeptiert |
| „Monnem ist Mannheim“ | „MON-nem“, IPA-Hinweis und ausdrücklich nicht französisch | 15 Credits | Weiterhin eigenwillige Aussprache, als Stilmerkmal akzeptiert |
Automatische Transkription war keine verlässliche Abnahme
Bei der Endkontrolle des zweiten Clips lieferten zwei automatische deutsche Transkriptionen unterschiedliche Ergebnisse. Betroffen waren ausgerechnet Wörter wie „Neckar“, „Rhein“, „Wasserturm“, „Kurpfalz“, „Heimat“ und „Scherz“. Das bedeutet nicht automatisch, dass jedes dieser Wörter im Video falsch gesprochen wurde. Rap, Musik und eine künstlich erzeugte Stimme sind auch für Spracherkennung eine schwierige Kombination.
Für die Freigabe blieb deshalb das vollständige menschliche Anhören entscheidend. Eine automatisch erzeugte Transkription kann auf mögliche Stellen hinweisen, aber sie ersetzt in diesem Fall keine Hörkontrolle.
Was danach in den Prompts stand
In späteren Lizzy-Prompts habe ich die sprachlichen Anforderungen noch expliziter formuliert: natürliche deutsche Aussprache, keine französische Färbung und bei wichtigen Ortsnamen zusätzliche Silbenhilfen. Das macht die Generierung nicht deterministisch, verbessert aber die Ausgangslage und dokumentiert klar, worauf bei der Abnahme zu achten ist.
Die Erfahrung hat außerdem meine Entscheidung verändert, wann ich eine Abweichung akzeptiere:
- Bei einer erfundenen Figur darf eine unerwartete Stimme bleiben, wenn sie glaubwürdig zum Charakter passt.
- Bei Ortsnamen, Erklärungen und fachlichen Aussagen muss die Aussprache verständlich und inhaltlich korrekt sein.
- Bei einer realen Person oder einer exakt vorgegebenen Stimme würde ich neu generieren oder die Tonspur ersetzen.
- Wenn die Abweichung Pointe oder Aussage beschädigt, ist sie kein Stilmerkmal, sondern ein Fehler.
Nicht jeder Fehler muss entfernt werden
Video-KI verlangt nicht nur Kontrolle, sondern auch eine gestalterische Entscheidung. Manche Abweichungen zerstören eine Szene. Andere eröffnen etwas, das im ursprünglichen Prompt nicht vorgesehen war. Lizzys Akzent gehörte für mich vorerst zur zweiten Gruppe.
Das macht den Prompt nicht unwichtig. Im Gegenteil: Erst weil die gewünschte Aussprache klar beschrieben war, ließ sich die Abweichung überhaupt sinnvoll bewerten. Der entscheidende Schritt kam danach – beim Anhören und bei der Frage, ob das Ergebnis für diese konkrete Figur funktioniert.